Дублікати сторінок — поширена SEO-проблема, яка може виникати через налаштування CMS, параметри URL, пагінацію, редизайн або помилки вебмайстра. Якщо однаковий чи дуже схожий контент доступний за кількома адресами, пошуковій системі доводиться визначати, яку URL вважати основною.
Розберемо повні й часткові дублікати, способи їх пошуку та основні методи усунення.
Що таке дублікати сторінок сайту
Дублікати сторінок — різні URL, за якими доступний однаковий або дуже схожий контент.
Проблема не в самому факті існування технічних варіантів URL, а в тому, що вони можуть потрапляти до індексу, конкурувати між собою, розпорошувати внутрішні та зовнішні сигнали й витрачати ресурси сканування.
- Індексація. На великому сайті тисячі зайвих URL можуть відволікати краулер від важливих нових сторінок.
- Зміна релевантної URL. Пошукова система може обрати для показу не ту версію, яку ви вважаєте основною.
- Внутрішні посилання. Якщо частина лінків веде на дублікати, структура стає менш послідовною. Дивіться внутрішню перелінковку.
- Зовнішні посилання. Беклінки можуть розподілятися між кількома URL замість однієї канонічної.
Види дублів
Повні дублікати
Повні дублікати мають практично однаковий контент, але різні адреси. Типові випадки:
- www і без www;
- http та https, якщо перенесення налаштоване неправильно;
- URL зі слешем і без слеша;
/і/index.phpабо інші службові суфікси;- різні шляхи до одного товару чи матеріалу;
- верхній і нижній регістр, якщо сервер трактує їх як різні адреси;
- параметри та UTM-мітки, які створюють індексовані копії;
- GET-параметри фільтрації й сортування;
- некоректна 404, що повертає 200 для випадкових URL;
- помилки реалізації мовних версій;
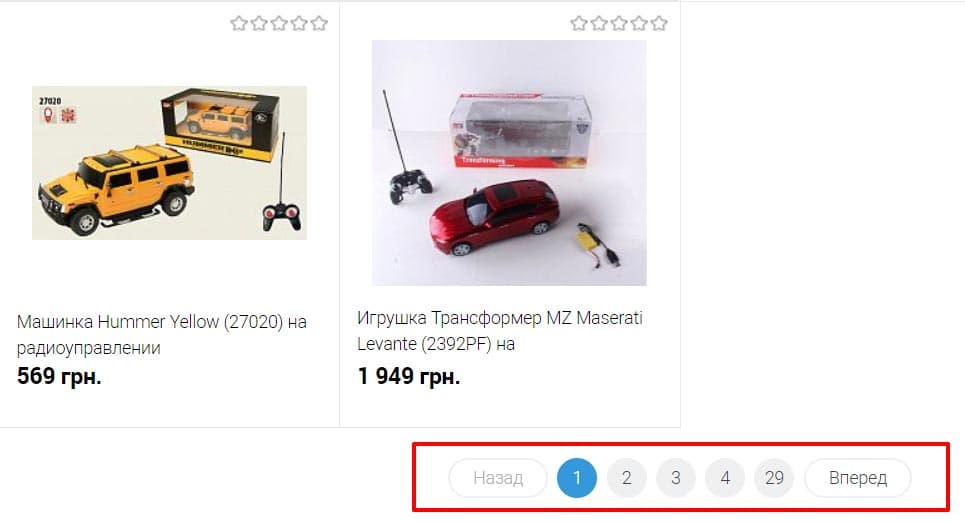
- перша сторінка пагінації, яка дублює категорію;
- зайві повторні слеші або інші варіанти нормалізації URL.
Такі дублікати часто з’являються після зміни CMS, переходу на HTTPS, редизайну або неправильних налаштувань маршрутизації.
Часткові дублікати
Часткові дублікати мають різний HTML або окремі елементи, але значна частина змісту повторюється. Типові приклади:
- фільтри, сортування, пошук і пагінація;
- сторінки коментарів чи відгуків із параметрами;
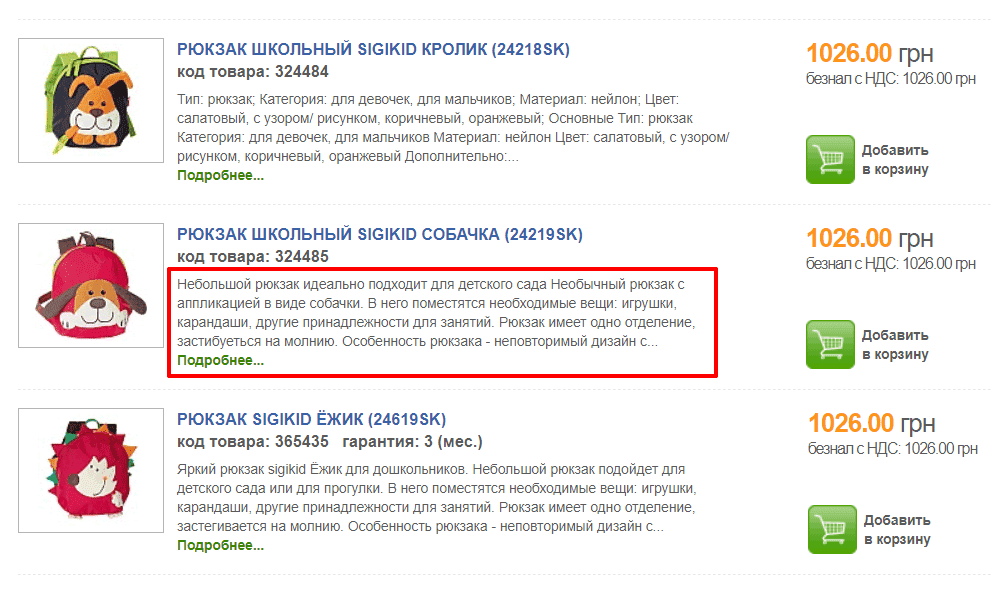
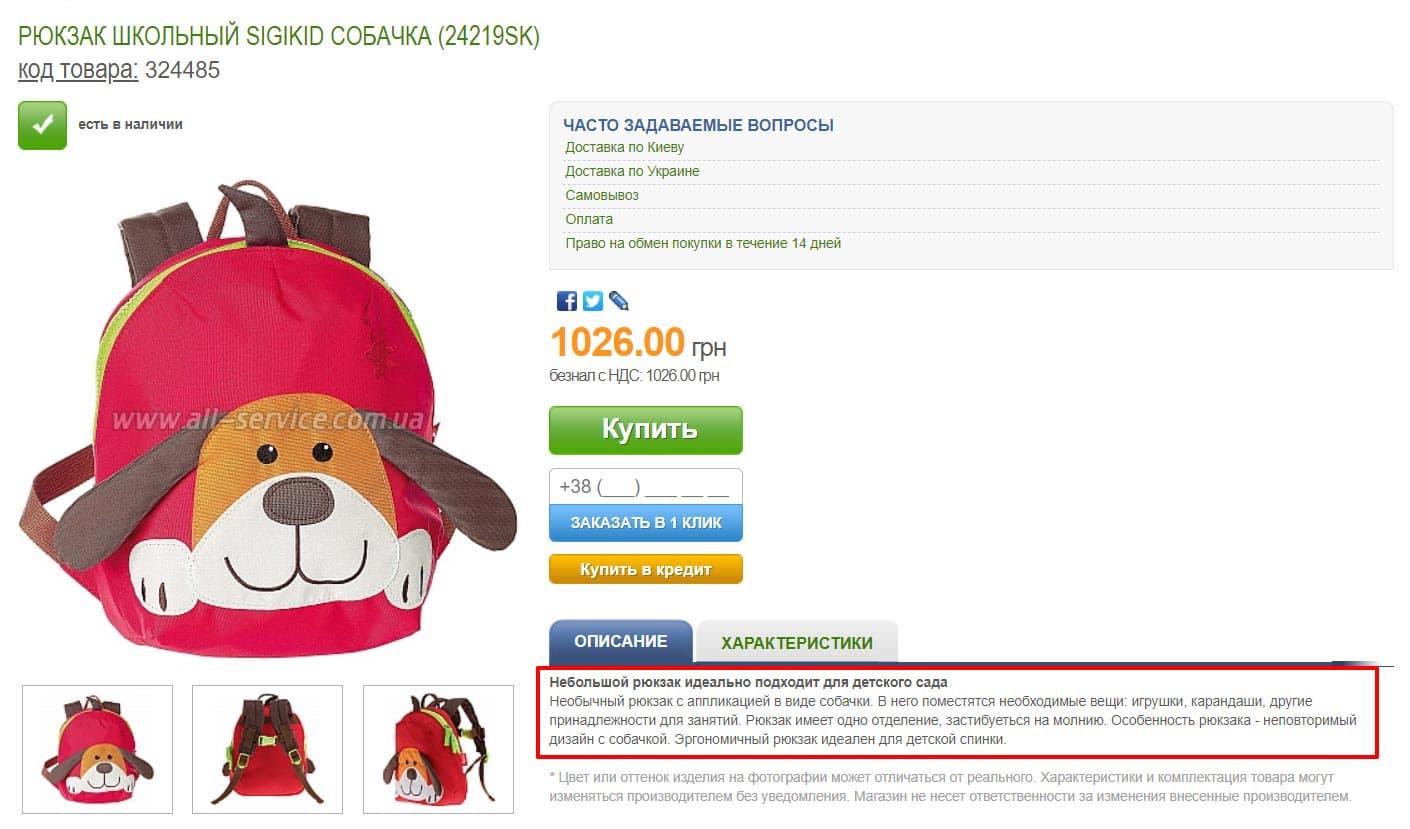
- категорії та картки товарів з однаковими описами;
- версія для друку або PDF, що повторює основний матеріал;
- кілька статей, створених під синонімічні запити з однаковим наміром.
Як знайти дублікати сторінок
Ручна перевірка
Для невеликого сайту частину проблем можна знайти вручну: перевірити основні варіанти домену, http/https, слеші, параметри, сторінки пагінації й пошукати фрагменти тексту в Google.
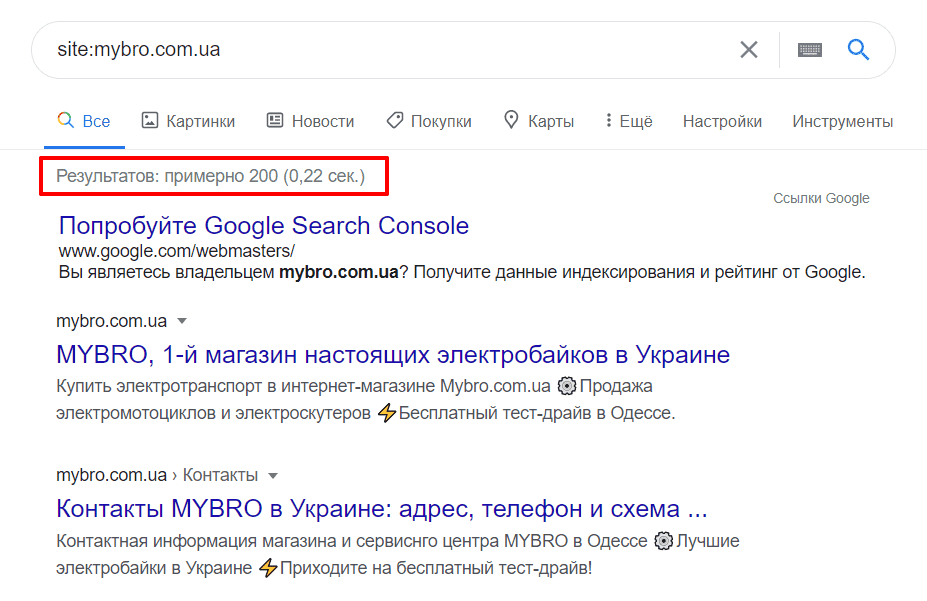
Оператор site: допомагає переглянути URL домену в пошуку, але не є точним лічильником індексованих сторінок. Для діагностики краще поєднувати його з Search Console та краулером.
Панелі вебмайстра
Google Search Console показує сторінки, які Google виявив, проіндексував або виключив, а також обрану канонічну URL для окремої сторінки. Це допомагає побачити, чи не індексуються небажані варіанти.
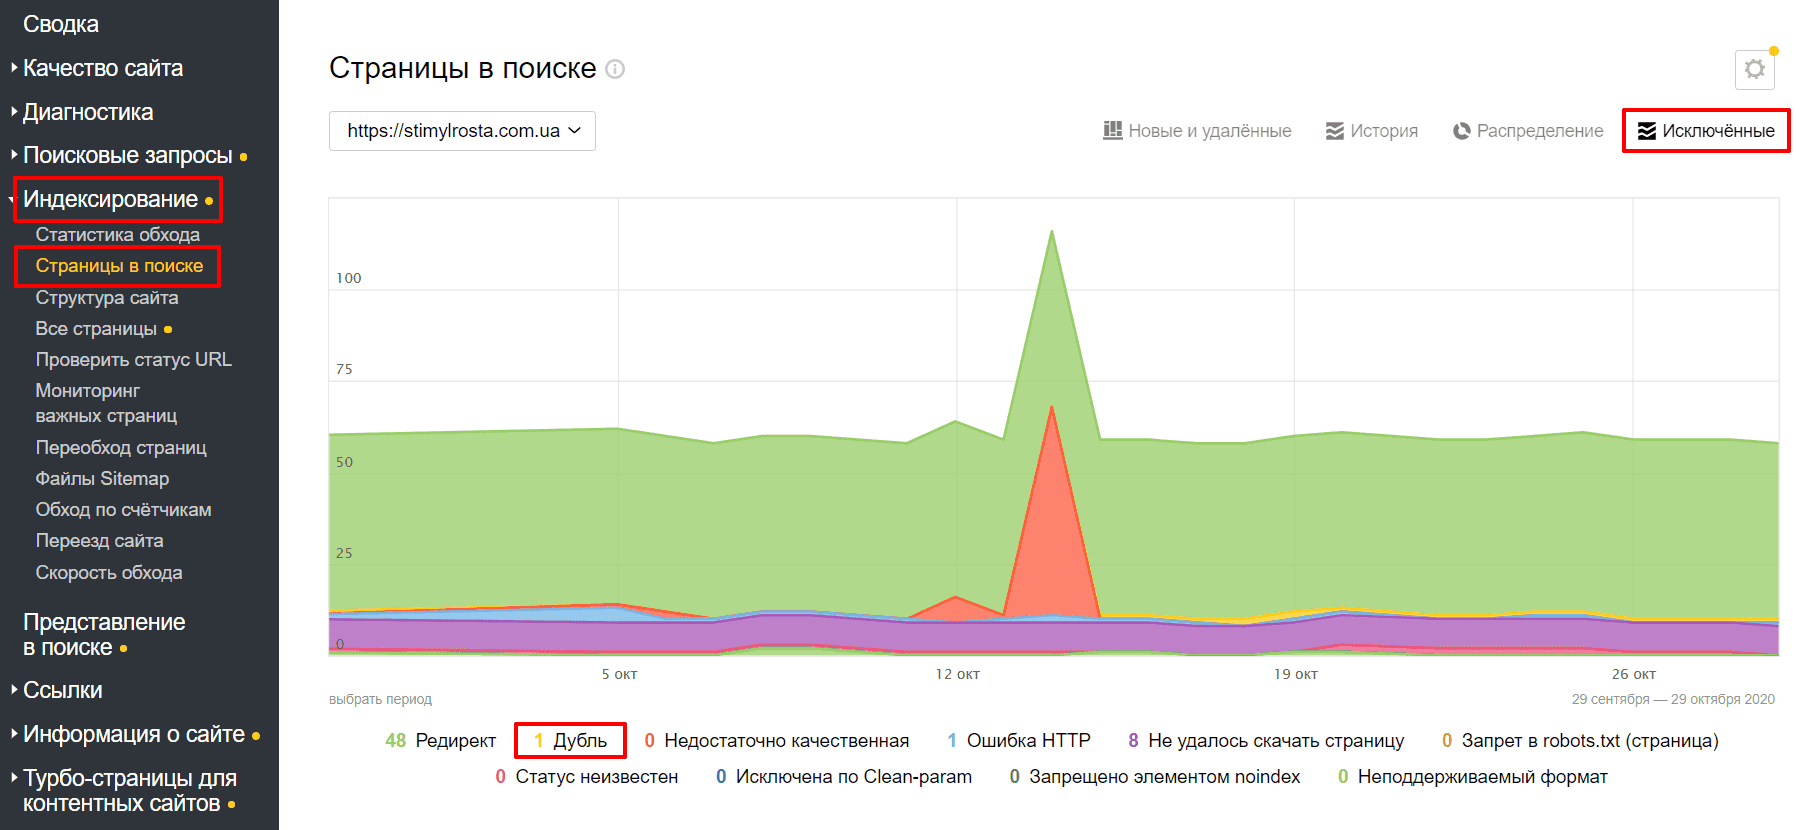
Онлайн-сервіси
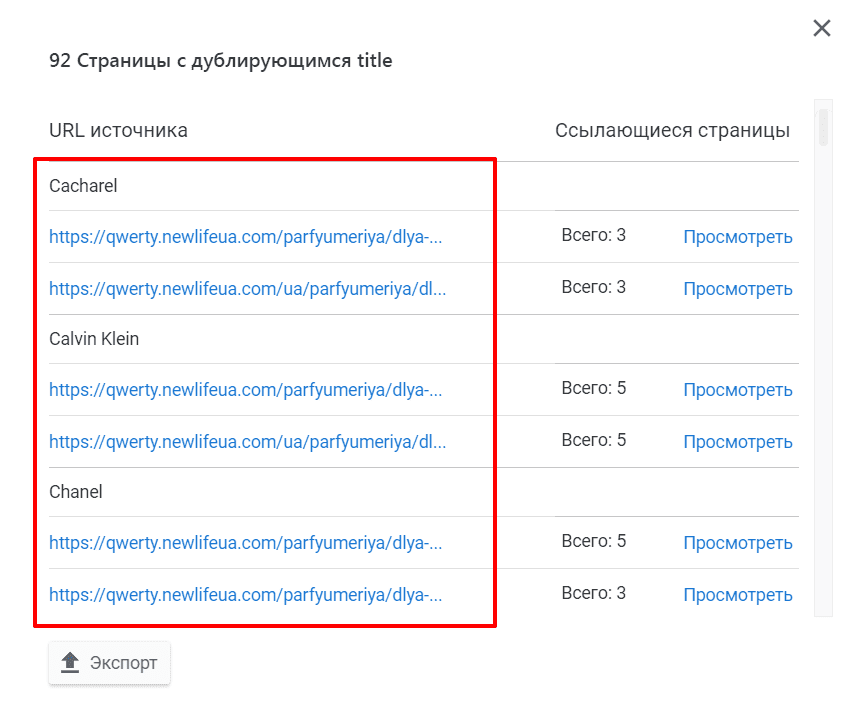
Спеціальні SEO-сервіси можуть знаходити дублікати Title, Description, H1 і схожі сторінки під час технічного аудиту.
Apollon
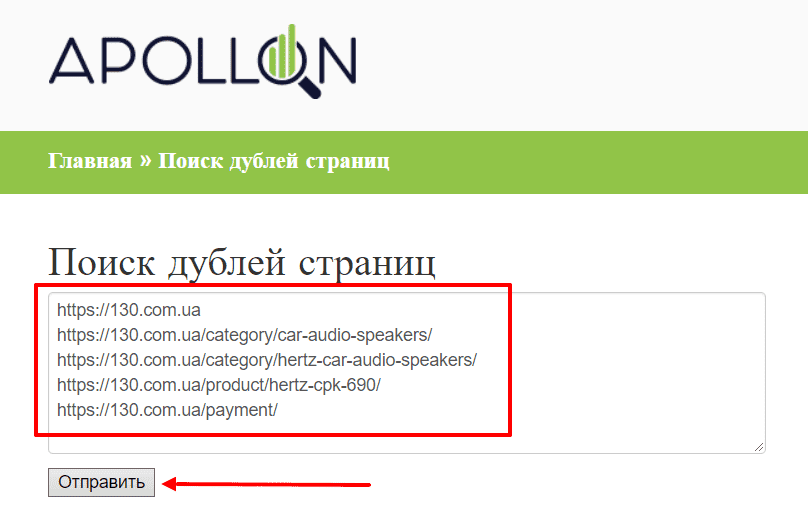
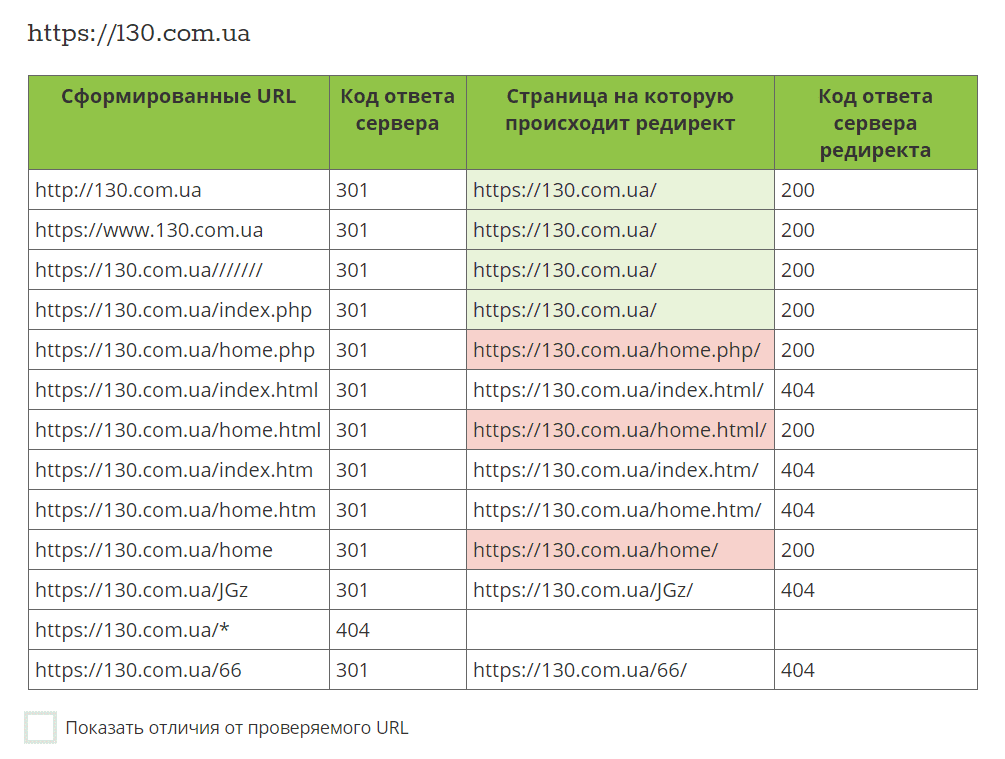
SE Ranking
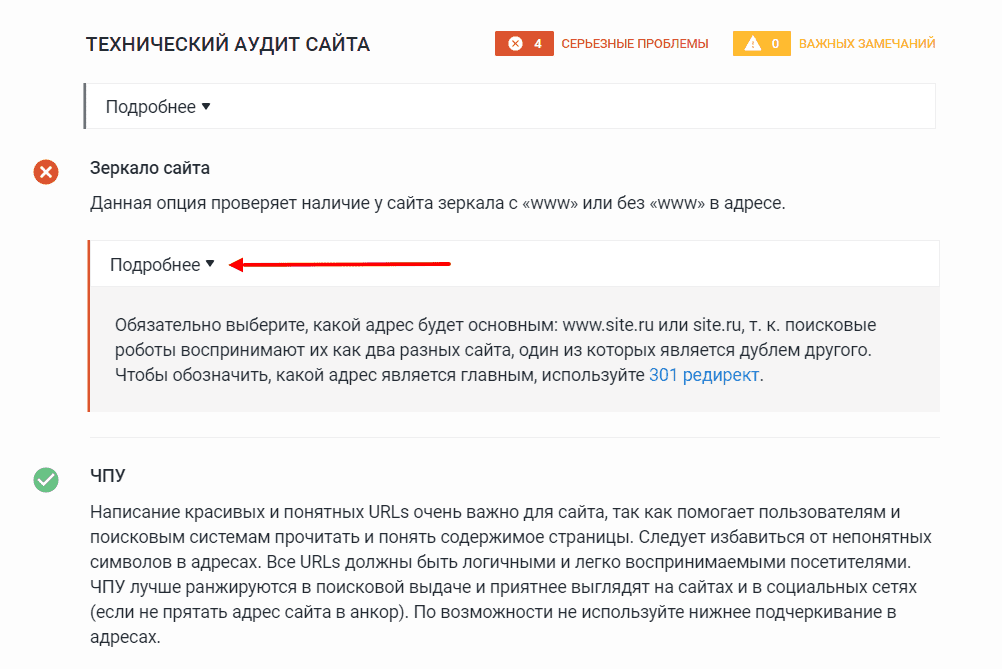
У технічному аудиті SE Ranking можна аналізувати дубльовані метадані та інші проблеми сторінок.
Пошук дублів за допомогою програм
Netpeak Spider
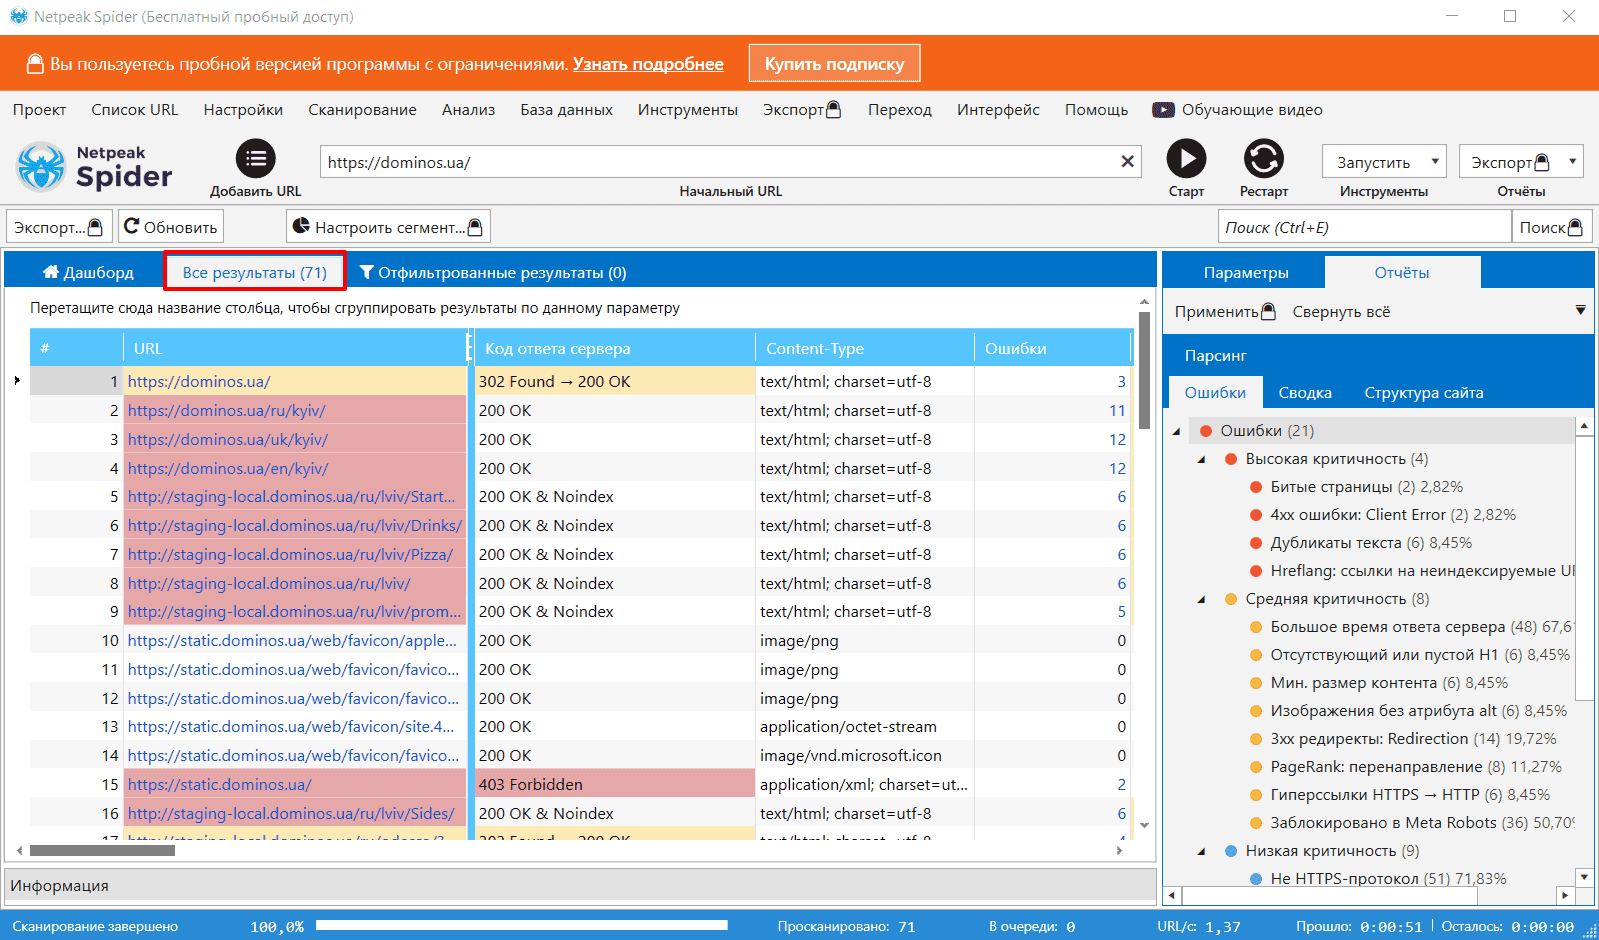
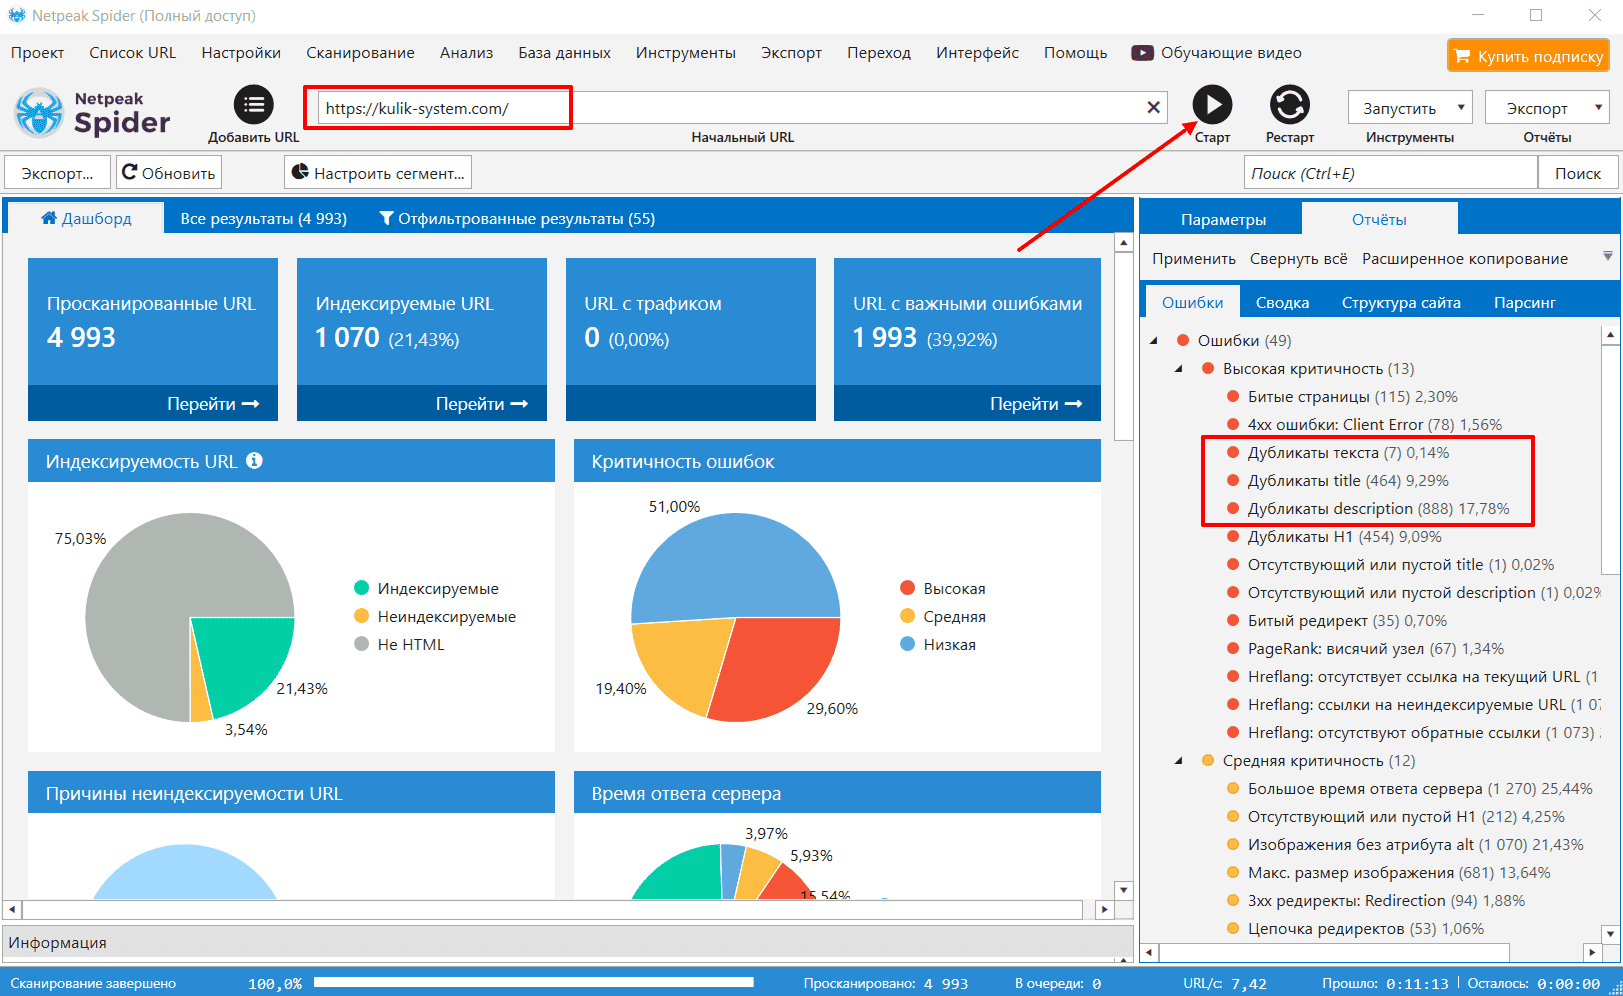
Краулер Netpeak Spider збирає URL сайту та дозволяє фільтрувати дубльовані Title, Description, H1, canonical й інші параметри.
Xenu
Xenu Link Sleuth — старий інструмент для обходу посилань. Він може бути корисним для пошуку технічних URL, але для сучасного комплексного SEO-аудиту зручніше використовувати актуальні краулери.
Як усунути дублікати сторінок
Метод залежить від того, навіщо існує альтернативна URL. Не потрібно бездумно застосовувати одне рішення до всіх випадків.
Meta robots
Якщо сторінка потрібна користувачам, але не повинна бути в індексі, можна застосувати noindex. При цьому пошуковий робот має мати можливість прочитати цю директиву.
301-редирект
Якщо дві URL фактично є одним ресурсом і альтернативна адреса більше не потрібна, постійний 301-редирект на основну сторінку зазвичай є найчистішим рішенням.
rel="canonical"
Canonical повідомляє пошуковій системі, яку URL ви вважаєте основною серед схожих варіантів. Це підказка, а не абсолютна заборона індексації.
robots.txt
Robots.txt керує скануванням, але сам по собі не є надійним способом видалити URL з індексу. Якщо робот не може зайти на сторінку, він також не побачить розміщений там noindex або canonical.
Крім того, виправляйте внутрішні посилання, sitemap і навігацію так, щоб вони вели безпосередньо на канонічні адреси.
Підсумок
Дублікати потрібно не просто «закривати від пошуку», а спочатку зрозуміти причину їх появи. Для непотрібних копій використовуйте редиректи або видалення, для потрібних альтернатив — canonical чи noindex, а технічні помилки краще усувати на рівні CMS і маршрутизації.


